Ciencia de datos industrial: dashboards, KPIs y analítica de planta
Integramos datos de PLC, SCADA, ERP, medidores y sensores para crear indicadores confiables, dashboards operativos y modelos de pronóstico. <strong>Transforme datos dispersos en decisiones</strong> sobre producción, calidad, mantenimiento y energía.
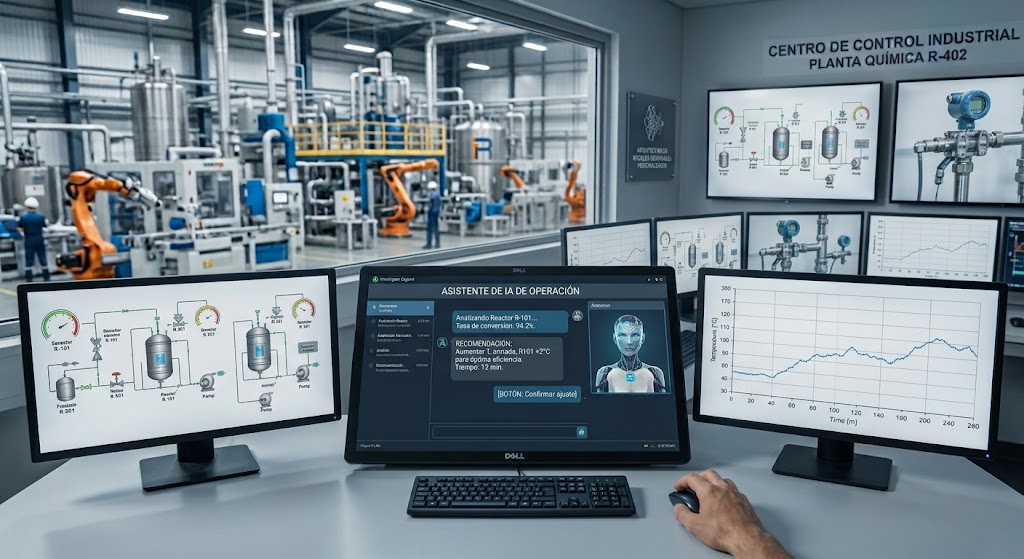
Antes de predecir con IA, hay que tener datos confiables
La mayoría de las plantas tienen datos — muchos datos. Están en el PLC, en el SCADA, en el historiador, en Excel del laboratorio, en el ERP. El problema no es la cantidad: es que están dispersos, sin contexto, sin validación, y nadie los cruza.
La ciencia de datos industrial es el paso entre capturar señales y tomar decisiones. Antes de entrenar un modelo de Machine Learning necesitas saber qué datos tienes, si son confiables, cómo se relacionan entre sí, y qué preguntas de negocio deben responder.
En DYMSY conectamos las fuentes de datos de planta (OPC UA, MQTT, bases SQL, APIs ERP), las limpiamos y contextualizamos, y construimos dashboards e indicadores que el gerente de planta puede usar mañana — no en 6 meses.
Alcance del servicio
Cada proyecto se define en un statement of work con entregables y criterios de aceptación explícitos. Los bloques típicos son:
Integración de fuentes OT/IT
Conexión de PLC, SCADA, historiadores (PI, InfluxDB), ERP (SAP, Oracle), MES y sensores IoT en un modelo de datos unificado.
Modelo de datos industrial
Esquema relacional que cruza producción, calidad, mantenimiento y energía. Definición de jerarquías ISA-95 (área, línea, equipo, componente).
Dashboards operativos
OEE por turno, Pareto de paros, tendencias de calidad, consumo energético por línea. Grafana, Power BI o plataforma web embebida en SCADA.
KPIs y reportes automáticos
Indicadores de producción (piezas/hora, scrap rate, MTBF, MTTR), reportes de turno generados automáticamente, alertas por desviación.
Data pipelines y ETL
Pipelines automatizados para extraer, transformar y cargar datos de múltiples fuentes. Validación de calidad de dato en cada etapa.
Pronósticos y analítica avanzada
Modelos estadísticos de demanda, tendencia de desgaste, consumo energético estacional. Base para escalar a ML cuando los datos estén listos.
Con qué trabajamos
Marcas y herramientas concretas del servicio. Los partnerships certificados están destacados.
Casos reales que hacemos
Ejemplos concretos de proyectos representativos. Para casos con métricas específicas de cliente, agende una llamada.
Dashboard OEE turno-por-turno en planta automotriz
Integración de 3 líneas de ensamble (PLC Siemens + historiador PI) con ERP SAP PP. Dashboard Grafana con drill-down a causa raíz de paro. Reducción de 18% en tiempo muerto no planeado en 4 meses.
Modelo de datos unificado para planta de alimentos
Cruce de datos SCADA (temperaturas, presiones), laboratorio (análisis fisicoquímico en Excel) y ERP (órdenes de producción). Pipeline ETL automatizado con Airflow. KPIs de calidad en tiempo real por primera vez.
Pronóstico de consumo energético por línea
Modelo estadístico con 18 meses de datos de submedidores. Predicción de kWh/turno con 92% de precisión. Identificación de 3 equipos con consumo anómalo — ahorro de $280k MXN/mes.
Lo que preguntan gerentes de planta e ingeniería
¿Cuál es la diferencia entre ciencia de datos e IA/Machine Learning?
¿Necesito un data lake para empezar?
¿Cuánto tiempo toma ver resultados?
¿Puedo usar los datos que ya tengo en mi historiador SCADA?
¿Qué pasa si mis datos están sucios o incompletos?
Que suelen combinarse con Ciencia de datos industrial
¿Tiene datos dispersos y quiere convertirlos en decisiones?
Consultoría técnica sin costo · Respuesta en 24 hrs · Cobertura nacional MX